¿Cuánta VRAM necesito para ejecutar IA en local?
Tabla rápida de memoria de gráfica por tamaño de modelo y cuantización, con ejemplos de tarjetas que funcionan para cada caso.
Este artículo contiene enlaces de afiliado: si compras a través de ellos podemos recibir una comisión, sin coste para ti. Más información.
Un modelo cuantizado a 4 bits (Q4_K_M) ocupa unos 0,6 GB por cada mil millones de parámetros, y a eso hay que sumar la memoria del contexto, que va de menos de 1 GB a varios GB. En la práctica, un modelo de 8B cabe en una gráfica de 8 GB, uno de 14B pide 12 GB y uno de 32B necesita unos 24 GB.
La VRAM es la memoria propia de la tarjeta gráfica, y en IA local es el dato que más manda. Para que un modelo responda rápido, sus pesos y la memoria de la conversación tienen que caber dentro de ella. Si no caben, el programa manda una parte a la RAM del ordenador y la velocidad se desploma. Puedes hacer el cálculo con tu gráfica concreta en la herramienta ¿qué IA puedo ejecutar?.
¿Cómo se calcula la memoria que ocupa un modelo?
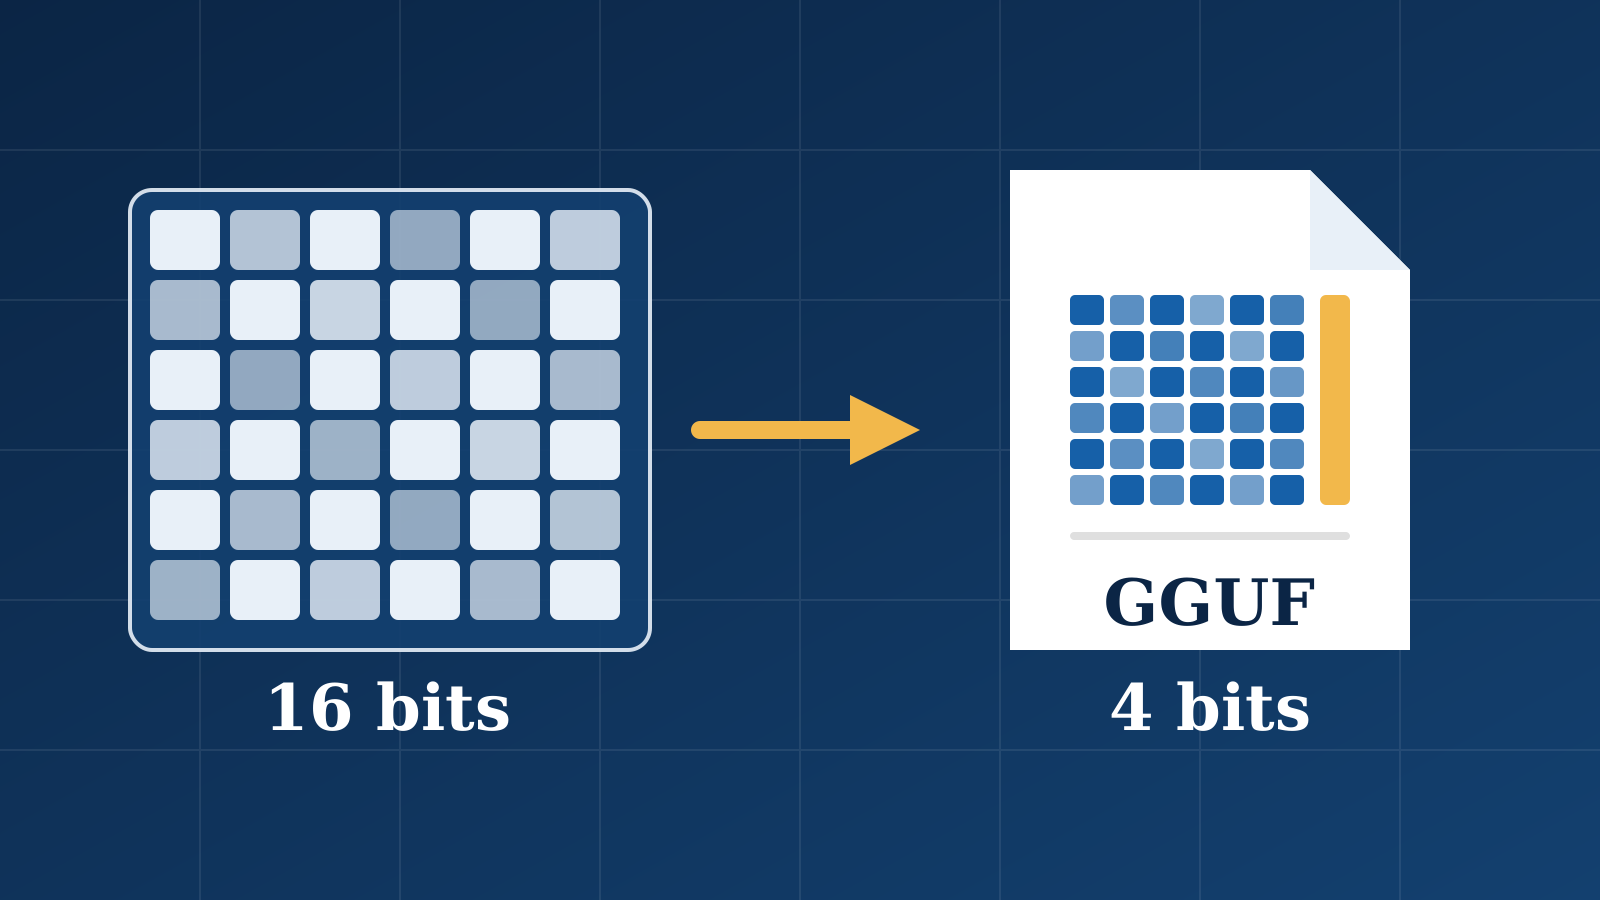
La cuenta básica es sencilla: número de parámetros × bits por parámetro ÷ 8. Un modelo de 8.000 millones de parámetros (8B) en 16 bits ocupa unos 16 GB; cuantizado a 4 bits, menos de un tercio. Los formatos GGUF más usados, como Q4_K_M, guardan en realidad algo más de 4 bits de media, así que la regla práctica es de unos 0,6 GB por cada mil millones de parámetros a 4 bits y algo más de 1 GB por cada mil millones a 8 bits. Si estos nombres te suenan a chino, lo explicamos en qué es la cuantización y el formato GGUF.
A eso hay que sumar dos cosas: la memoria del contexto (la caché KV, que veremos abajo) y un pequeño margen para el propio programa y los búferes de cálculo.
¿Cuánta VRAM necesita cada tamaño de modelo?
Estos son los tamaños reales de los archivos GGUF publicados en Hugging Face para modelos habituales. Son la cifra mínima: el contexto va aparte.
| Tamaño | Modelo de ejemplo | Q4_K_M | Q8_0 | Gráfica orientativa (4 bits) |
|---|---|---|---|---|
| 8B | Qwen3-8B | 5,0 GB | 8,7 GB | 8 GB (justo) o 12 GB (cómodo) |
| 14B | Qwen3-14B | 9,0 GB | 15,7 GB | 12 GB o 16 GB |
| 32B | Qwen3-32B | 19,8 GB | 34,8 GB | 24 GB o 32 GB |
| 70B | Llama 3.3 70B | 42,5 GB | 75,0 GB | 2 × 24 GB, 48 GB o Mac con 64 GB o más |
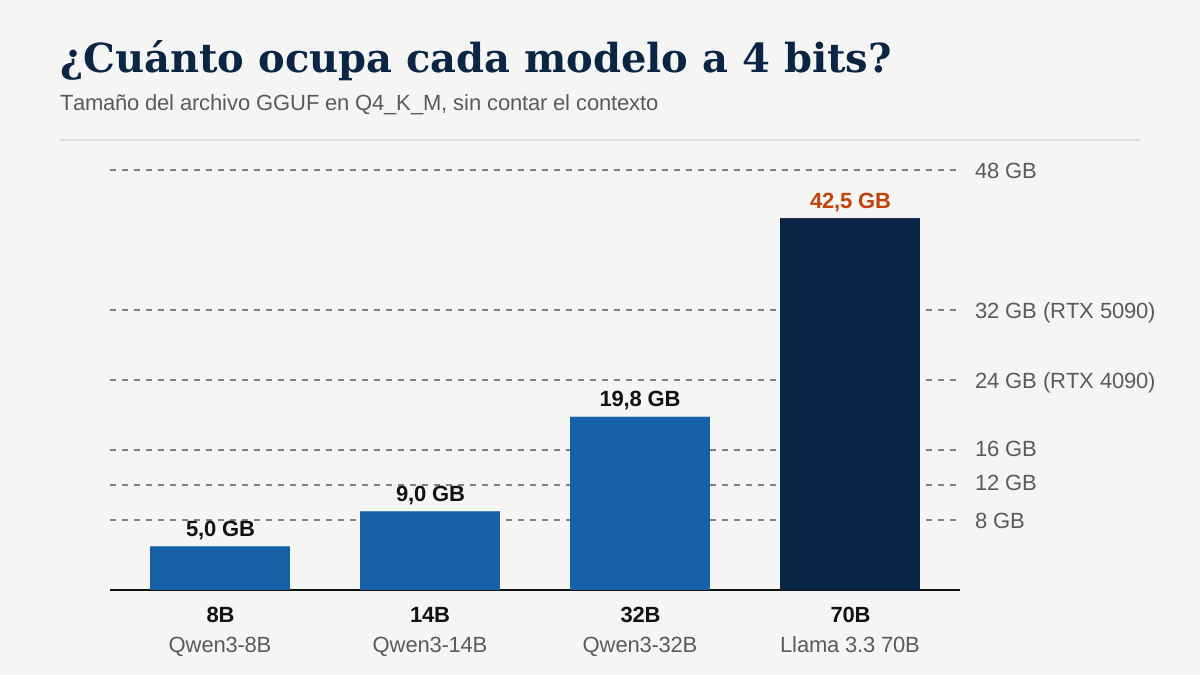
El mantenedor de muchas de estas versiones cuantizadas en Hugging Face da un consejo práctico: si quieres que todo vaya en la gráfica, elige un archivo entre 1 y 2 GB más pequeño que tu VRAM. Ese margen es el que se come el contexto en conversaciones normales.
¿Qué más ocupa VRAM además del modelo?
El gran olvidado es el contexto. Mientras el modelo lee y escribe, guarda información de cada token en la llamada caché KV, y esa caché crece en línea recta con la longitud de la conversación o del documento.
Su tamaño depende de la arquitectura: 2 × capas × cabezas KV × dimensión de cada cabeza × bytes por valor, por cada token. En Qwen3-8B (36 capas, 8 cabezas KV de 128 dimensiones, en 16 bits) salen unos 147 KB por token. Parece poco, pero se multiplica:
- 4.096 tokens de contexto: unos 0,6 GB.
- 16.384 tokens: unos 2,4 GB.
- 32.768 tokens: unos 4,8 GB, casi tanto como el propio modelo.
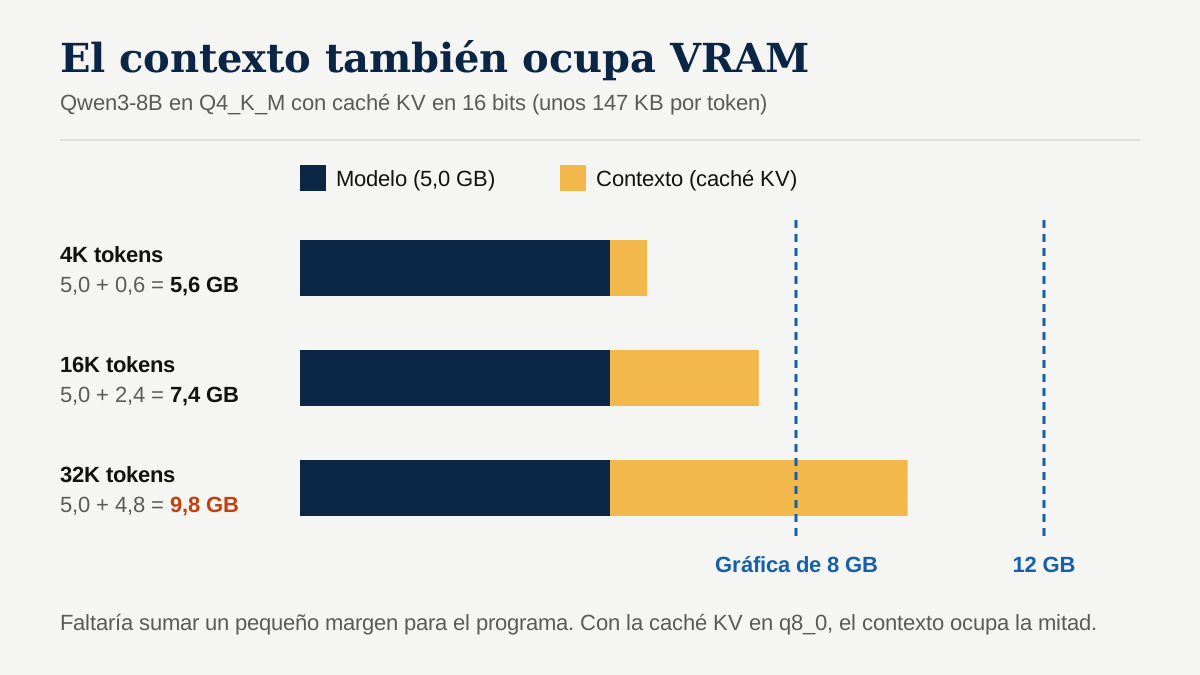
Por eso Ollama ajusta el contexto por defecto según la memoria que detecta: 4K tokens con menos de 24 GiB de VRAM, 32K entre 24 y 48 GiB, y 256K a partir de 48 GiB. Si subes el contexto a mano (Ollama recomienda al menos 64K para agentes, búsqueda web o herramientas de programación), vigila que siga cabiendo.
Dos ajustes ayudan a ahorrar memoria de contexto: la flash attention, que Ollama activa automáticamente donde es compatible, y la cuantización de la caché KV (OLLAMA_KV_CACHE_TYPE=q8_0), que según su documentación reduce esa memoria a la mitad aproximadamente.
¿Qué pasa si el modelo no cabe en la gráfica?
Las herramientas basadas en llama.cpp, como Ollama o LM Studio, no se niegan a cargarlo: ponen en la gráfica las capas que caben y el resto en la RAM, donde las procesa la CPU. Funciona, pero la caída de velocidad es brusca, porque la parte lenta marca el ritmo.
En una prueba publicada por InventiveHQ con un modelo de 14B en Q4_K_M y una RTX 5060 Ti de 16 GB, el modelo entero en la gráfica generaba 43 tokens por segundo; con solo 8 de sus 48 capas en la CPU bajaba a 12,5, y todo en la CPU se quedaba en 2,9.
Si te quedas corto, tienes tres salidas, por este orden:
- Reducir el contexto si no necesitas conversaciones o documentos largos.
- Bajar un escalón de cuantización (por ejemplo, de Q5 a Q4_K_M, o a Q3_K_M), aceptando algo de pérdida de calidad.
- Elegir un modelo más pequeño.
¿Y los modelos MoE, los Mac y los equipos con memoria unificada?
Modelos MoE (mezcla de expertos). En cada paso solo trabaja una parte de los parámetros, lo que los hace rápidos, pero hay que cargarlos enteros. Ocupan según su tamaño total, no según los parámetros activos. Por ejemplo, gpt-oss-20b tiene 21.000 millones de parámetros, de los que usa 3.600 millones en cada paso, y OpenAI indica que funciona con 16 GB de memoria. Qwen3-30B, también MoE, ocupa 19 GB en la biblioteca de Ollama.
Mac con Apple Silicon. La memoria es compartida entre CPU y gráfica, así que un Mac con 64 o 128 GB puede cargar modelos que no caben en ninguna gráfica doméstica. Pero macOS reserva una parte para el sistema: por defecto, la gráfica puede usar en torno al 75 % de la memoria total. En un Mac de 64 GB eso deja unos 48 GB, suficientes para un 70B en Q4_K_M con poco contexto.
Equipos con memoria unificada grande. Los miniPC con mucha memoria compartida y equipos como el NVIDIA DGX Spark siguen la misma lógica que un Mac: mucha capacidad, aunque normalmente con menos ancho de banda que una gráfica dedicada de gama alta, lo que se nota en la velocidad.
¿Qué gráfica elegir según lo que quieras ejecutar?
| VRAM | Qué puedes ejecutar con soltura | Ejemplos de gráficas |
|---|---|---|
| 8 GB | Modelos de 7–8B en 4 bits con contexto corto | RTX 4060, RTX 5060, RX 7600 |
| 12 GB | 8B con contexto amplio o 14B en 4 bits | RTX 3060 12 GB, RTX 5070, Arc B580 |
| 16 GB | 14B con margen, MoE como gpt-oss-20b | RTX 5060 Ti 16 GB, RTX 5070 Ti, RX 9070 XT |
| 24 GB | 32B en 4 bits | RTX 3090, RTX 4090, RX 7900 XTX |
| 32 GB | 32B con más contexto o mejor cuantización | RTX 5090 |
| 48 GB o más | 70B en 4 bits | Dos gráficas de 24 GB, Mac o equipos de memoria unificada |
Si estás pensando en comprar, en qué gráfica comprar para IA local comparamos opciones por precio y compatibilidad.
¿Cuál elegimos? Nuestra recomendación
Para la mayoría, 16 GB de VRAM es hoy el punto dulce: caben con holgura los modelos de 14B y algunos MoE de unos 20B, con contexto de sobra para conversaciones y documentos. Con 12 GB se puede trabajar bien con modelos de 8B y, más justo, de 14B. 8 GB sirve para empezar, pero limita mucho. Y si tu objetivo son los modelos de 32B, apunta a 24 GB o más. Sea cual sea tu gráfica, la regla de oro es la misma: elige un archivo 1–2 GB más pequeño que tu VRAM y comprueba con ollama ps que todo va en la GPU.
La experiencia más repetida entre los usuarios del foro de Privacy Guides coincide con esto: el modelo tiene que caber entero en la VRAM o se vuelve muy lento, 8 GB se quedan cortos, 12 GB permiten modelos de 8B a 14B y a partir de 16 GB hay margen. Y en los foros de desarrolladores de Apple, varios usuarios confirman el límite de alrededor del 75 % de la memoria unificada para la gráfica en los Mac.
Preguntas frecuentes
¿Puedo usar la RAM del ordenador si no me llega la VRAM?+
Sí. Ollama, LM Studio y llama.cpp reparten el modelo entre gráfica y RAM, pero la velocidad cae mucho en cuanto una parte de las capas pasa a la CPU. Sirve para probar un modelo, no tanto para usarlo a diario.
¿Sirve un Mac para IA local?+
Sí. Los Mac con Apple Silicon comparten la memoria entre CPU y gráfica, así que un Mac con mucha memoria unificada puede cargar modelos grandes. Eso sí, por defecto macOS solo deja a la gráfica una parte de esa memoria, en torno al 75 % según los desarrolladores.
¿Cómo sé si el modelo cabe entero en la gráfica?+
En Ollama, ejecuta ollama ps mientras el modelo está cargado. Si la columna PROCESSOR indica 100% GPU, cabe entero; si aparece un reparto CPU/GPU, parte del modelo o del contexto se ha ido a la RAM.
¿Cuánta memoria necesita un modelo MoE como gpt-oss-20b?+
En los modelos de mezcla de expertos (MoE) hay que cargar todos los parámetros, aunque en cada paso solo se usen unos pocos. Por eso ocupan como su tamaño total. OpenAI indica que gpt-oss-20b, con 21.000 millones de parámetros, funciona con 16 GB de memoria.
Fuentes
- Hugging Face: Qwen3-8B GGUF (tamaños por cuantización)
- Hugging Face: Qwen3-14B GGUF (tamaños por cuantización)
- Hugging Face: Qwen3-32B GGUF (tamaños por cuantización)
- Hugging Face: Llama 3.3 70B Instruct GGUF (tamaños y consejo de elección)
- Hugging Face: configuración de Qwen3-8B
- Hugging Face: gpt-oss-20b
- Ollama: biblioteca Qwen3
- Ollama: longitud de contexto
- Ollama: preguntas frecuentes (caché KV, ollama ps)
- InventiveHQ: prueba de descarga parcial de capas en llama.cpp
- Apple Developer Forums: recommendedMaxWorkingSetSize
- Privacy Guides Community: pasar de ChatGPT a modelos locales
- NVIDIA: GeForce RTX 5090