¿Qué es la cuantización (Q4, Q8, GGUF) en los modelos de IA?
Qué es la cuantización de modelos de IA, qué significan Q4, Q5, Q8 y GGUF, cuánto ocupa un modelo según su cuantización y cuánta calidad se pierde.
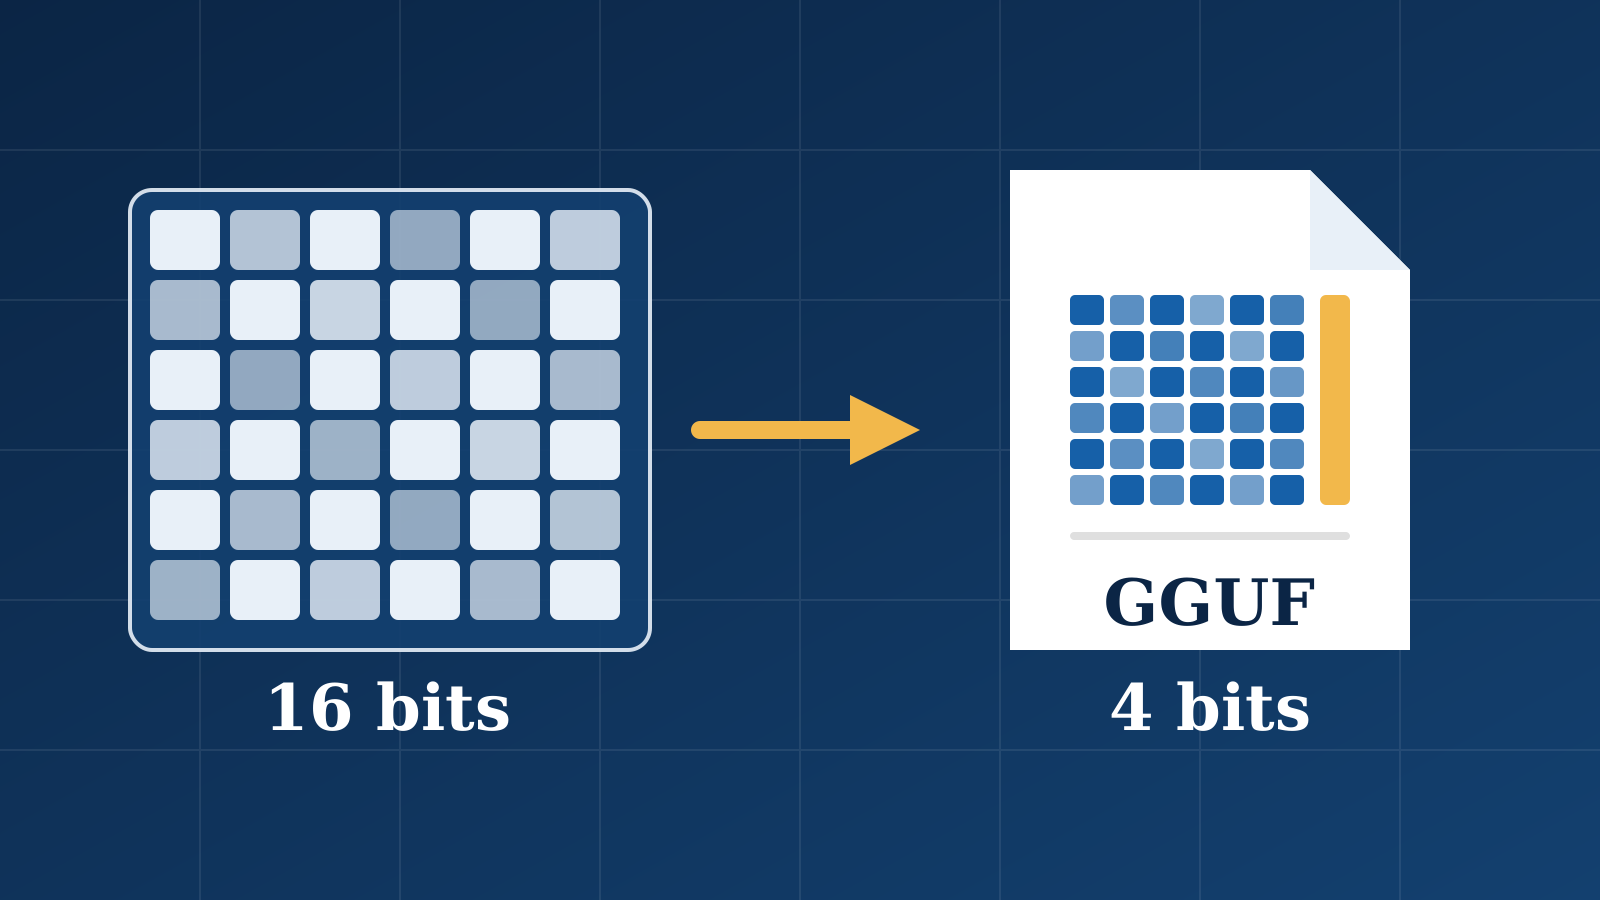
Ilustración: Criterio Tech
Este artículo contiene enlaces de afiliado: si compras a través de ellos podemos recibir una comisión, sin coste para ti. Más información.
La cuantización reduce la precisión de los números que forman un modelo de IA para que ocupe menos y quepa en tu gráfica o tu RAM. Q8 usa unos 8,5 bits por parámetro y apenas pierde calidad; Q4_K_M usa unos 4,9 bits, ocupa en torno al 30 % del original y es el equilibrio más habitual. GGUF es el formato de archivo que usan llama.cpp, Ollama o LM Studio para guardar estos modelos.
Si has buscado un modelo para ejecutar en local, te habrás encontrado con nombres como Q4_K_M, Q8_0 o IQ3_M y archivos que terminan en .gguf. No son caprichos: indican cuánto se ha comprimido el modelo, y de eso depende si cabe en tu gráfica, lo rápido que responde y lo bien que lo hace.
¿Qué significa cada cuantización, de un vistazo?
| Cuantización | Bits por parámetro | Tamaño frente a 16 bits | Pérdida de calidad (orientativa) |
|---|---|---|---|
| F16 / BF16 | 16 | 100 % | Ninguna (referencia) |
| Q8_0 | ~8,5 | ~53 % | Muy pequeña, difícil de notar |
| Q6_K | ~6,6 | ~41 % | Muy pequeña |
| Q5_K_M | ~5,7 | ~36 % | Pequeña |
| Q4_K_M | ~4,9 | ~31 % | Pequeña a moderada; el equilibrio habitual |
| Q3_K_M | ~4,0 | ~25 % | Notable, sobre todo en modelos pequeños |
| IQ2 / Q2_K | ~2,4–3 | ~15–20 % | Alta; solo como último recurso |
Los bits por parámetro son los que publica el repositorio de llama.cpp para un modelo real: no son números redondos porque cada bloque de pesos guarda además su escala, y las variantes _M combinan distintos niveles en distintas partes del modelo. La pérdida de calidad es orientativa y varía según el modelo y la tarea.
¿Por qué hace falta cuantizar?
Un modelo de lenguaje está formado por miles de millones de parámetros, y cada uno es un número que hay que guardar en memoria. La cuenta es sencilla:
Tamaño ≈ número de parámetros × bits por parámetro ÷ 8
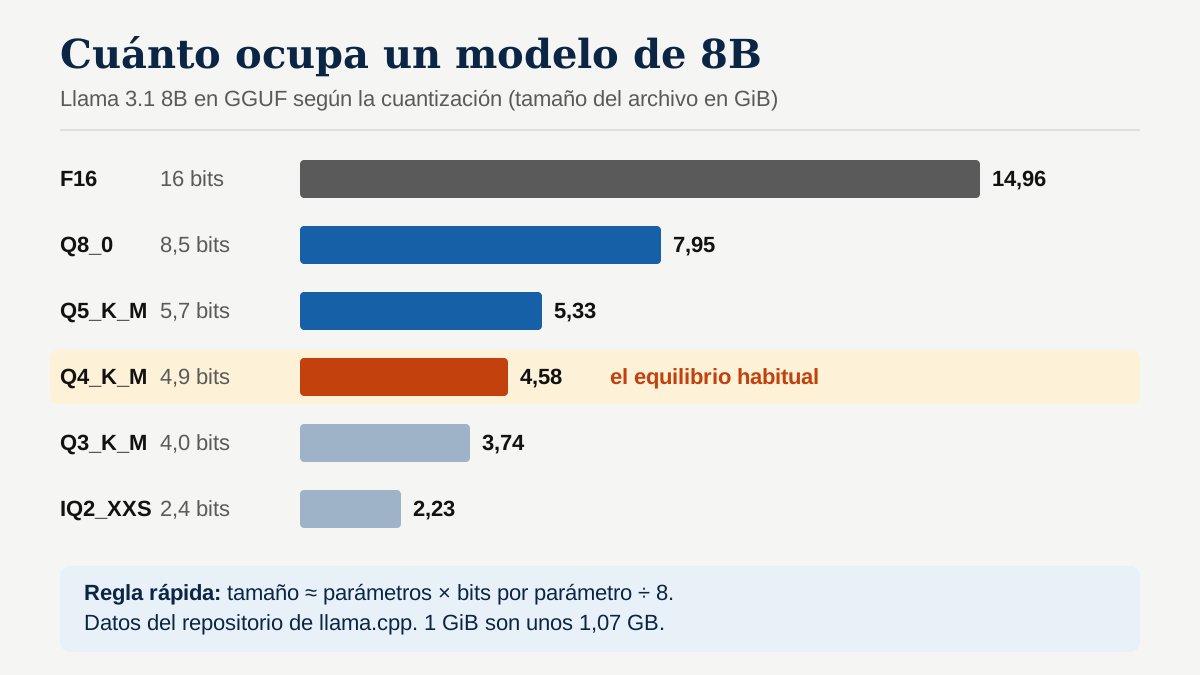
Por ejemplo, con Llama 3.1 8B (unos 8.000 millones de parámetros), estos son los tamaños reales que publica llama.cpp:
| Formato | Bits por parámetro | Tamaño del archivo |
|---|---|---|
| F16 | 16 | 14,96 GiB (~16 GB) |
| Q8_0 | 8,5 | 7,95 GiB (~8,5 GB) |
| Q5_K_M | 5,7 | 5,33 GiB (~5,7 GB) |
| Q4_K_M | 4,9 | 4,58 GiB (~4,9 GB) |
A esto hay que sumar la memoria que necesita el contexto (la conversación y los documentos que le pasas), que crece cuanto más largo es.
Si quieres profundizar en la memoria de la gráfica, tienes nuestra guía de cuánta VRAM necesito.
¿Qué significa Q4, Q5 o Q8?
El número indica, de forma aproximada, cuántos bits se usan por parámetro. Menos bits significa un archivo más pequeño, pero también menos precisión.
En los modelos GGUF verás nombres como Q4_K_M o Q5_K_S:
- Q4, Q5, Q6, Q8: bits aproximados.
- K: los métodos “k-quant” de llama.cpp, que agrupan los pesos en superbloques con escalas propias y reparten mejor la precisión. Hoy son los más usados.
- S, M, L: variante pequeña, mediana o grande. La M es la más habitual como equilibrio.
- _0 y _1 (como Q4_0 o Q8_0): los métodos originales, más simples. Hugging Face los considera ya heredados, aunque Q8_0 sigue siendo muy común.
- IQ (por ejemplo IQ2_XXS, IQ3_S o IQ4_XS): métodos que usan una matriz de importancia (imatrix) para proteger los pesos que más influyen y así perder menos calidad en tamaños muy reducidos.
También empiezan a aparecer formatos como MXFP4, un formato de 4 bits en coma flotante por bloques que algunos modelos, como gpt-oss, usan de origen.
¿Cuánta calidad se pierde?
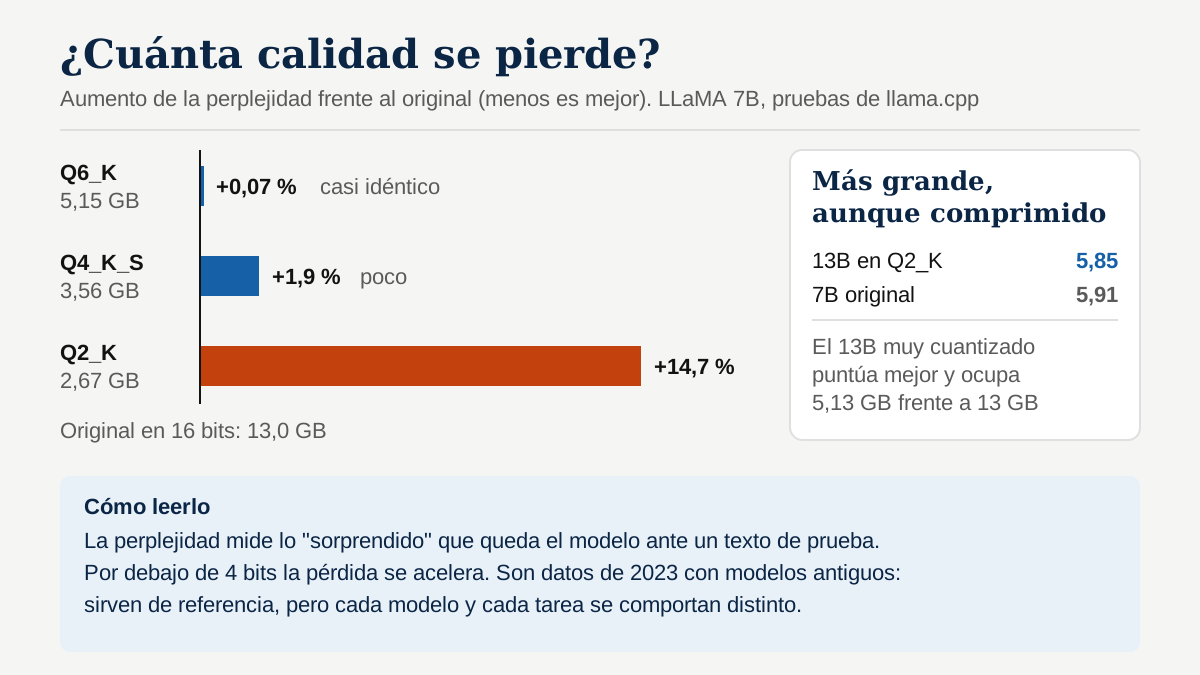
La forma habitual de medirlo es la perplejidad: cuánto “se sorprende” el modelo ante un texto de prueba. Cuanto menor, mejor. En las pruebas con las que llama.cpp presentó los k-quants en 2023, con LLaMA 7B:
- Q6_K quedó prácticamente igual que el original (+0,07 %).
- Q4_K_S subió la perplejidad en torno a un 2 %.
- Q2_K la subió casi un 15 %.
Las tendencias que se repiten:
- Q8 es prácticamente indistinguible del original en el uso diario.
- Q6 y Q5 pierden muy poco.
- Q4 (sobre todo las variantes K_M) es el punto dulce para la mayoría: se nota poco en conversación y tareas generales.
- Por debajo de Q4 la degradación se acelera: respuestas menos coherentes, más errores en razonamiento, código o idiomas distintos del inglés.
- Más parámetros suele compensar: en esas mismas pruebas, el modelo de 13B en Q2_K (5,13 GB) obtuvo mejor perplejidad que el de 7B sin cuantizar (13 GB).
Ojo con una idea muy extendida: que los modelos grandes “toleran mejor” la cuantización. En las pruebas de llama.cpp, el error relativo no bajó de forma constante al crecer el modelo; lo que ocurre es que un modelo grande parte de un nivel más alto y, aunque pierda algo, sigue por delante.
¿La cuantización hace el modelo más rápido?
Sí, al generar texto. Para escribir cada palabra el equipo tiene que leer el modelo entero de la memoria, así que un archivo más pequeño se lee antes. En las pruebas publicadas en el repositorio de llama.cpp con Llama 3.1 8B, la versión Q4_K_M generaba unos 72 tokens por segundo, frente a unos 51 de la Q8_0 y unos 29 de la versión de 16 bits, en el mismo equipo.
El salto más grande, de todos modos, se da cuando el modelo cabe entero en la VRAM. Si una parte se va a la RAM del sistema, la velocidad cae mucho, sea cual sea la cuantización.
¿Qué es exactamente GGUF?
GGUF es un formato de archivo binario creado por Georgi Gerganov, autor de llama.cpp, para guardar modelos listos para ejecutar. A diferencia de formatos que solo guardan los pesos, como safetensors, un archivo GGUF incluye en un único fichero los pesos (normalmente cuantizados) y un conjunto estándar de metadatos: arquitectura, tokenizador, plantilla de chat, etc.
Ventajas:
- Un solo archivo, fácil de descargar y mover.
- Carga rápida y funciona en CPU, GPU o repartido entre ambas, lo que permite ejecutar modelos aunque no quepan enteros en la gráfica (más lento, eso sí).
- Lo usan las herramientas más populares de IA local: llama.cpp, LM Studio, GPT4All y Ollama.
En Hugging Face es habitual encontrar el mismo modelo en muchas versiones GGUF, una por cada cuantización; la propia web incluye un visor que muestra los metadatos y la precisión de cada tensor. Ollama puede descargar directamente esas versiones con ollama run hf.co/usuario/repositorio:Q4_K_M, y si no indicas cuantización elige Q4_K_M cuando está disponible. Si dudas entre herramientas, mira nuestra comparativa Ollama vs LM Studio.
¿Hay otros formatos además de GGUF?
Sí. Algunos de los que verás:
| Formato | Uso habitual |
|---|---|
| GGUF | IA local con llama.cpp, Ollama, LM Studio; CPU y GPU |
| Safetensors (FP16/BF16) | Modelos originales sin cuantizar, para entrenar o servir con mucha memoria |
| GPTQ / AWQ / EXL2 | Cuantizaciones orientadas a GPU con otros motores de inferencia |
| MLX | Modelos optimizados para Mac con Apple Silicon |
Para empezar en casa, GGUF es la opción más sencilla y compatible.
¿Cómo elijo la cuantización adecuada?
- Mira cuánta memoria tienes: VRAM de la gráfica o memoria unificada si usas un Mac.
- Elige el modelo más grande que quepa en Q4_K_M dejando margen para el contexto. Como referencia, Gemma 3 en Q4_K_M ocupa 3,3 GB en 4B, 8,1 GB en 12B y 17 GB en 27B.
- Si te sobra espacio, sube a Q5_K_M o Q6_K antes que pasar a un modelo enorme que no quepa entero.
- Si no te cabe, baja de tamaño de modelo antes que bajar a Q2 o Q3. Si tienes que bajar de 4 bits, prefiere las variantes IQ hechas con matriz de importancia.
- Evita que el modelo se reparta entre GPU y RAM si buscas velocidad: funciona, pero mucho más lento.
Si estás valorando ampliar el equipo, tienes nuestra guía de qué gráfica comprar para IA local.
¿Cuál elegimos? Nuestra recomendación
Para la mayoría de usuarios, Q4_K_M es la cuantización por defecto: ocupa poco, mantiene buena calidad y permite usar modelos más grandes en gráficas domésticas. Si tu equipo va sobrado, Q5_K_M o Q6_K son una mejora sencilla, y Q8_0 es para cuando quieres la máxima fidelidad y te sobra memoria. Por debajo de Q4, úsalo solo si es la única forma de ejecutar un modelo concreto y prueba siempre si el resultado te convence.
Según los usuarios que comparan cuantizaciones en Hacker News, con modelos recientes de unos 27B la diferencia entre BF16 y Q8_0 es prácticamente nula (del orden de un 0,1–0,3 % de perplejidad) y la de Q4_K_M ronda el 1–3 %, difícil de notar en el uso normal. No todos coinciden: otros avisan de que en modelos como Llama 3.3 ya se aprecia algo de degradación al pasar de Q5 a Q4, así que si te cabe, Q5_K_M es una apuesta más segura.
Preguntas frecuentes
¿Qué cuantización debo elegir?+
Como punto de partida, Q4_K_M suele ser el mejor equilibrio entre tamaño y calidad, y es la que Ollama usa por defecto en muchos modelos. Si te sobra memoria, sube a Q5_K_M o Q6_K; si no te cabe, baja de tamaño de modelo antes que irte a Q2 o Q3.
¿Es mejor un modelo grande en Q4 o uno pequeño en Q8?+
En general, el modelo con más parámetros cuantizado suele rendir mejor que uno más pequeño con más bits que ocupe lo mismo. En las pruebas originales de llama.cpp, un modelo de 13B en Q2_K puntuó mejor que uno de 7B sin cuantizar. Aun así, depende del modelo y de la tarea, así que conviene probar.
¿Qué significan las letras K, M o S en Q4_K_M?+
Son variantes del método de cuantización de llama.cpp. La K indica los métodos 'k-quant', que agrupan los pesos en bloques con su propia escala, y la S, M o L el tamaño relativo (pequeño, mediano, grande): más grande, algo más de calidad y más espacio.
¿La cuantización hace el modelo más rápido?+
Normalmente sí al generar texto, porque hay menos datos que leer de la memoria. En las pruebas publicadas en el repositorio de llama.cpp con Llama 3.1 8B, la versión Q4_K_M generaba unos 72 tokens por segundo frente a unos 29 de la versión de 16 bits en el mismo equipo. El gran salto llega cuando el modelo cabe entero en la gráfica.
Fuentes
- llama.cpp (GitHub)
- llama.cpp: documentación de la herramienta quantize (tamaños y velocidades de Llama 3.1 8B)
- llama.cpp, pull request #1684: k-quants (resultados de perplejidad)
- Hugging Face: documentación de GGUF y tipos de cuantización
- Hugging Face: usar Ollama con modelos GGUF del Hub
- Biblioteca de modelos de Ollama: gemma3
- Hacker News: comentario sobre la pérdida de calidad de Q8_0 y Q4_K_M (abril de 2026)
- Hacker News: comentario sobre la degradación de Q5 a Q4 en Llama 3.3 (abril de 2025)